从少数�帖~图像中学习
一般的应用仅需要约20到50张图像进行训练即可。当然图像越多训练效果越好,但我们的软件根据训练库的主要参数属性,内部将自动产生数以千计新的人造图像,让训练更有效率。

运行在GPU和CPU
为了让训练更有效率,需要新一代的图形处理器(GPU)。在生产线上,您可以视需选用GPU或CPU,而GPU的处理时间会比CPU快3到10倍。 (Object Classification的运行速度CPU和GPU一�岱�)。

最佳性能
一般在GPU的训练时间大约是5到15分钟。推理时间的长短每张图像介于5到100毫秒,它和选用的工具与硬件有关。工业级的推理引擎WEAVER可以保证最佳的性能。
训练步骤
1.收集图像并进行图像归一化
采集20到50张图像,好坏都要,图像要尽可能涵盖物件的变化,并储存到硬盘里。
确认图像上被测物的尺寸,方向,照明尽可能保持一致性。
2.训练
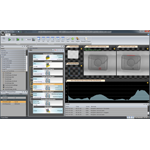
打开Adaptive Vision Studio并选择Deep Learning的其中一个工具
打开工具中的编辑器,并载入图像
开始标注图像或使用绘图工具做标记(您也可以从Zillin汇入资料)
点击 “训练”
训练集与验证集
在深度学习中如同在机器学习的各个领域一�屆A遵循正确的方法是非常重要的。最重要的规则是将训练集和验证集分开。训练集是用于创建模型的一组�帖~图像。我们不能用它来衡量模型的性能,因为这通常会产生过于乐观的结果。因此,我们使用不同的数据(验证集)来评估模型。我们的深度学习工具会根据用户提供的�帖~图像自动创建这两种资料集。
3.执行
运行程式并查看结果
返回到步骤1或步骤2,直到获得满意的效果。
FAQ
Adaptive Vision 深度学习插件与TensorFlow或PyTorch有什么不同?
TensorFlow和PyTorch主要是面向程序员和热衷编程爱好者的低级框架。 假如贵公司有自己的研发团队,则可能会尝试使用这些工具从头到脚构建自己的解�角霈蛂C 尽管创建一个可行的功能演示一般需要几天的时间,但是要创建一个可用于生产环境的系统可能至少需要花费几个月的时间, 甚至到几年,如果您希望达到最高的性能。与此相反,我们的深度学习插件是一个完整且现成的解�角霈蛂C 它已经在100多个项目中进行了现场测试并且您今天即可开始使用!
既然我可以选择开源的神经网络库,为何还应该使用 Adaptive Vision 的深度学习插件?
除了五个经过优化的神经网络设计外、此解�角霈�还包括:一套图形工具能使数据注释和模型培训更加方便、训练数据的高级扩充和自动平衡、用于数据预处理且合并规算法和机器学习的一套方法、经过优化的内存管理、技术支持和我们的专有技术等其他的优势和功能。我们深度学习插件经过许多年的开发,测试和微调让您立即将其实施到您项目中并且使用较小的图像集进行训练。此解�角霈蛈b较低成本的同时,性能远高于开放源代码的框架。